
“Claude 5.5 mi, ChatGPT 6 Astra mı?” sorusunun teknik karşılığı Claude Opus 5.5 ile GPT-6 Astra karşılaştırması. Claude 5.5 bir model ailesinin adı; bu yazı 22 Eylül 2026'da çıkan Opus 5.5'i, OpenAI'ın GPT-6 Astra modeliyle karşılaştırıyor. ChatGPT ise Astra'ya erişilen ürünlerden biri.
Kısa cevap: ajan tabanlı kodlama, uzun bilgi işi ve API maliyeti önceliğinizse Claude Opus 5.5 daha güçlü aday. Bilimsel araştırma ajanı, OpenAI araç ekosistemi ve ChatGPT/Codex içindeki bütünleşik üretim akışı önceliğinizse GPT-6 Astra daha uygun olabilir. Beş ortak benchmarkta Claude üç, Astra iki testte önde. Fakat FrontierCode ve AutomationBench farkları küçük; tek bir “mutlak kazanan” ilan etmek veriyi olduğundan kesin gösterir.
Bu karşılaştırmadaki rakamlar 23 Eylül 2026 tarihinde Anthropic'in Claude Opus 5.5 duyurusu, Claude Platform model dokümantasyonu, OpenAI'ın GPT-6 Astra duyurusu ve OpenAI API model sayfası üzerinden kontrol edildi. Şirket iddiaları ile teknik özellikleri ayrı tuttum; farklı ölçü birimlerini aynı grafiğe sıkıştırmadım.
Hızlı karar: Claude Opus 5.5 standart API liste fiyatında hem girdi hem çıktı için Astra'dan yüzde 60 daha düşük. Astra 1,05 milyon token ile yaklaşık yüzde 5 daha geniş bağlam sunuyor; standart maksimum çıktı iki modelde de 128 bin token. Ortak test tablosunda Claude kodlama ve çok alanlı akıl yürütmede, Astra iş akışı otomasyonu ve bilimsel terminal araştırmasında öne çıkıyor.
Claude Opus 5.5 ve GPT-6 Astra temel özellikleri
Claude Opus 5.5
- Yayın tarihi: 22 Eylül 2026
- Bağlam penceresi: 1.000.000 token
- Standart maksimum çıktı: 128.000 token
- Bilgi kesim tarihi: Haziran 2026
- API fiyatı: 4 dolar girdi, 20 dolar çıktı / milyon token
- Girdi ve çıktı: Metin ve görsel girdi, metin çıktı
- Model kimliği: claude-opus-5-5
GPT-6 Astra
- Yayın tarihi: 3 Eylül 2026
- Bağlam penceresi: 1.050.000 token
- Standart maksimum çıktı: 128.000 token
- Bilgi kesim tarihi: 30 Nisan 2026
- API fiyatı: 10 dolar girdi, 50 dolar çıktı / milyon token
- Girdi ve çıktı: Metin ve görsel girdi, metin çıktı
- Model kimliği: gpt-6-astra
Tablodaki fiyatlar standart API liste fiyatlarıdır. Toplam fatura yalnızca girdi ve çıktı tokenından oluşmayabilir. Cache yazma ve okuma, araç çağrıları, fast mode, batch kullanımı ve uzun bağlam kuralları maliyeti değiştirir. OpenAI dokümantasyonu, 272 bin tokenı aşan girdilerde tüm isteğin girdi ve cache fiyatının iki katına, çıktı fiyatının 1,5 katına çıktığını ayrıca belirtiyor. Büyük dosya yığınında yalnızca temel fiyat satırına bakmak bu yüzden yetersiz.
Benchmark grafiği: Aynı tabloda karşılaştırılabilen beş test
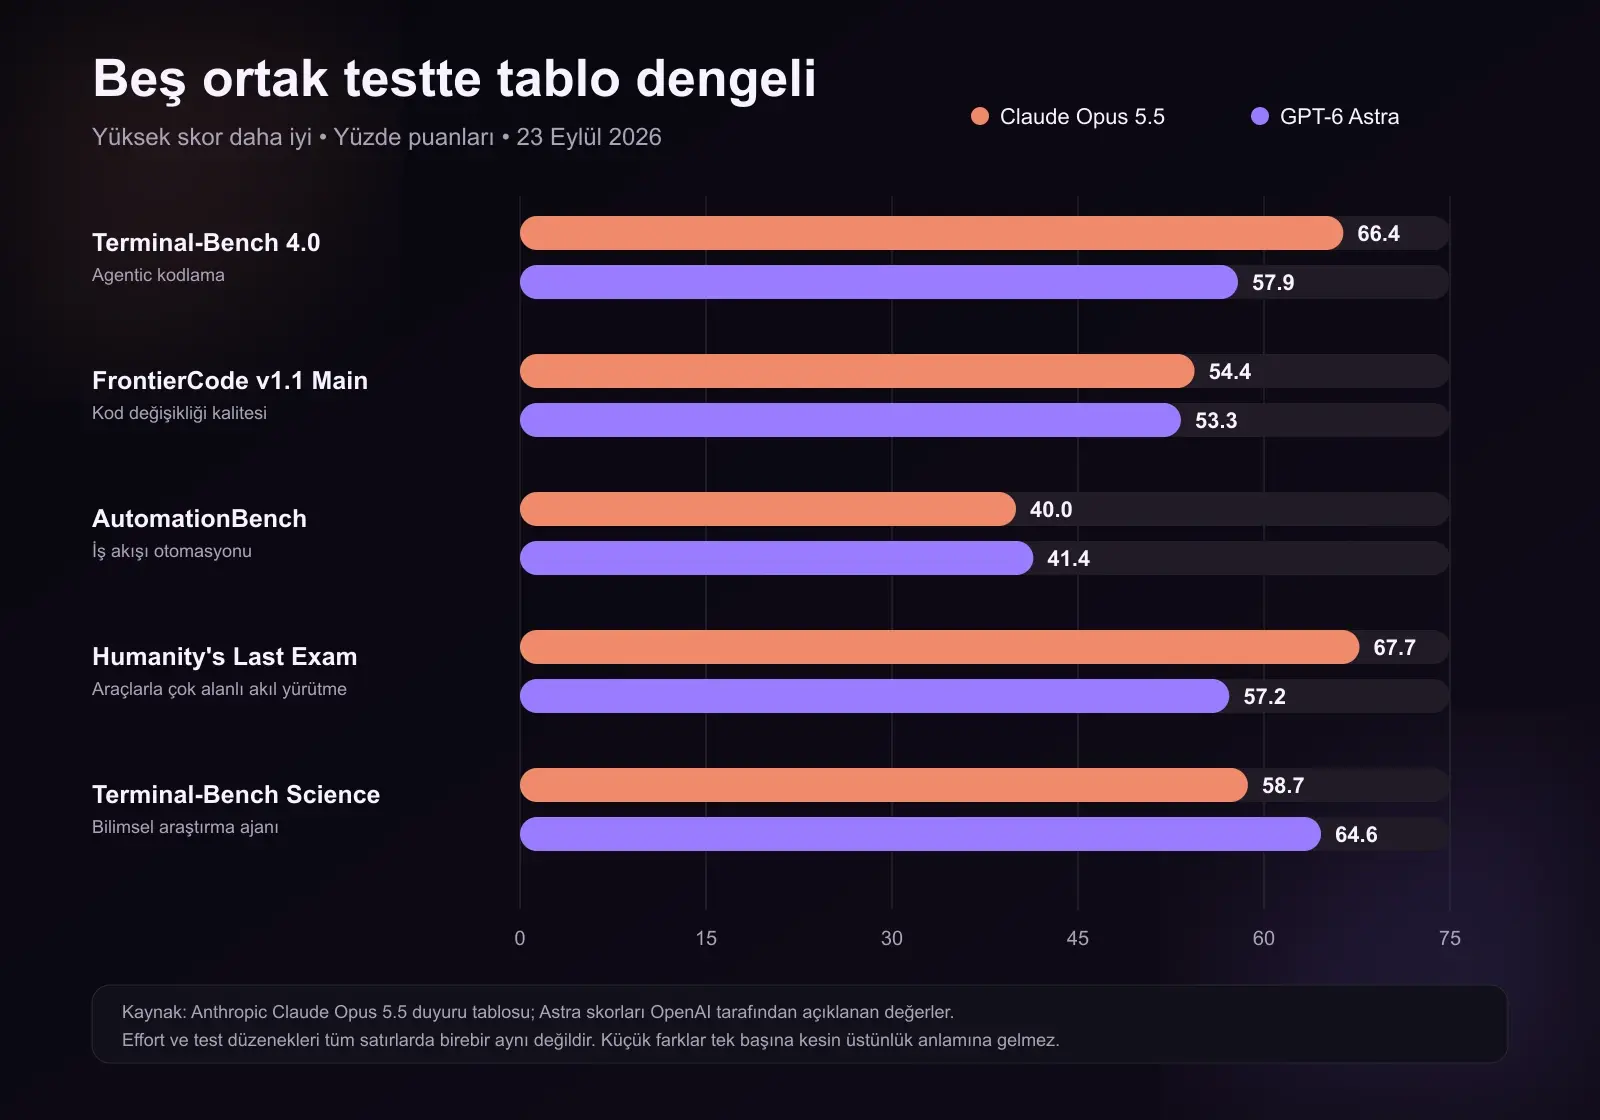
Grafikteki beş satır Anthropic'in lansman tablosunda iki model için birlikte verilen sonuçlardan oluşuyor. Astra'nın değerleri Anthropic tarafından yeniden üretilmiş değil; OpenAI'ın açıkladığı değerler kullanılmış. Sonuçların özeti:
- Terminal-Bench 4.0: Claude Opus 5.5 yüzde 66,4; GPT-6 Astra yüzde 57,9.
- FrontierCode v1.1 Main: Claude yüzde 54,4; Astra yüzde 53,3.
- AutomationBench: Claude yüzde 40,0; Astra yüzde 41,4.
- Humanity's Last Exam, araçlarla: Claude yüzde 67,7; Astra yüzde 57,2.
- Terminal-Bench Science 0.1: Claude yüzde 58,7; Astra yüzde 64,6.
Claude beş testin üçünde, Astra ikisinde daha yüksek skor alıyor. Yine de “3-2 kazandı” şeklindeki skor tabelası tek başına model seçimi değildir. Testler farklı becerileri ölçüyor ve her birinin işinizdeki ağırlığı aynı değil. Bir yazılım ekibi için Terminal-Bench, araştırma laboratuvarı için Terminal-Bench Science, çok sayıda uygulamayı birbirine bağlayan operasyon ekibi için AutomationBench daha önemli olabilir.
Rakamları neden temkinli okumalıyız?
Anthropic, aksi belirtilmedikçe Opus 5.5 sonuçlarının adaptive thinking ve maksimum effort ile alındığını söylüyor. Terminal-Bench satırında Opus 5.5 xhigh, Astra high effort kullanıyor; şirket bu değerlerin her iki model için açıklanan en yüksek skor olduğunu belirtiyor. Claude üretim güvenlik önlemleri açıkken değerlendirilmiş ve bazı hassas görevlerde eski modele geri dönüş uygulanmış.
Belirsizlik aralıkları da önemli. Anthropic, Terminal-Bench için Opus 5.5 standart hatasını artı eksi 2,6 puan; Terminal-Bench Science için model başına artı eksi 3,5 ila 5 puan olarak açıklıyor. Bu bilgi, FrontierCode'daki 1,1 puan ve AutomationBench'teki 1,4 puan farkı “kesin üstünlük” diye sunmamamız gerektiğini gösteriyor. Büyük farklar yön verir; küçük farklar gerçek projenizle doğrulanmalıdır.
OpenAI da kendi Astra tablosundaki skorların herhangi bir effort seviyesinde alınan en yüksek sonuç olduğunu ve araştırma ortamı ile üretim ChatGPT deneyiminin sistem mesajı ile araç farkları nedeniyle ayrışabileceğini yazıyor. Kısacası benchmark, direksiyon seçimi için harita sunar; varış garantisi vermez.
Kodlama için hangisi daha iyi?
Bugünkü resmî ortak verilere göre uzun süre çalışan kodlama ajanında Claude Opus 5.5 daha avantajlı görünüyor. Terminal-Bench 4.0'da 8,5 puanlık fark var. FrontierCode ana sette fark yalnızca 1,1 puan olsa da Claude aynı zamanda daha düşük standart token fiyatına sahip.
Terminal-Bench; yazılım geliştirme, sistem yapılandırması ve veri analizi gibi terminal üzerinden yürütülen çok adımlı görevleri ölçüyor. FrontierCode ise bir ajanın yaptığı kod değişikliklerinin birleştirilebilir kalitede olup olmadığına odaklanıyor. Bu iki test, yalnızca bir fonksiyon yazmaktan daha geniş bir tablo sunuyor: depoyu okuma, değişikliği planlama, dosyalara uygulama ve sonucu doğrulama.
Anthropic, Opus 5.5'in varsayılan medium effort ayarında FrontierCode'da yüzde 54,6 aldığını ve Astra'nın en yüksek yüzde 53,3 sonucunu görev başına yaklaşık beşte bir maliyetle geçtiğini iddia ediyor. Terminal-Bench'te ise varsayılan ayardaki Claude'un Astra düzeyine yaklaşık yüzde 40 görev maliyetiyle ulaştığını söylüyor. Bunlar bağımsız fatura ölçümü değil, Anthropic'in kendi maliyet analizidir; yine de token liste fiyatlarıyla aynı verim yönünü gösteriyor.
GPT-6 Astra'nın kodlamada zayıf olduğu sonucu çıkarılmamalı. OpenAI tablosunda Astra Terminal-Bench'te yüzde 57,9, DeepSWE v1.1'de yüzde 74,1, FrontierCode Extended'da yüzde 64,5 ve FrontierCode Main'de yüzde 53,3 alıyor. Codex'teki bağlam notları ve önceki bağlam pencerelerini arama özelliği de çok uzun geliştirme oturumlarında ürün düzeyinde avantaj sağlayabilir. Model benchmarkı ile onu çevreleyen ajan ürününü ayrı değerlendirmek gerekir.
Kodlama kararı
- Büyük depo göçü, uzun denetim ve API maliyeti hassasiyeti: Claude Opus 5.5 ile başlayın.
- Codex, OpenAI araçları ve mevcut ChatGPT iş akışına sıkı bağlı ekip: GPT-6 Astra'yı gerçek depo üzerinde karşılaştırın.
- Bir veya iki puanlık benchmark farkı için tüm altyapıyı taşımayın; hata oranı, inceleme süresi ve görev başı maliyeti ölçün.
Bilimsel araştırma ve çok alanlı akıl yürütme
Bu başlıkta sonuç ikiye ayrılıyor. Terminal-Bench Science 0.1; kod ve terminal araçlarıyla veri analizi, simülasyon ve model uydurma gibi bilimsel araştırma iş akışlarını ölçüyor. Astra yüzde 64,6 ile Claude'un yüzde 58,7 skorunun önünde. Bilimsel terminal işi sizin ana kullanımınızsa Astra lehine anlamlı bir sinyal var.
Humanity's Last Exam ise birçok alanda zor soruları ve araç kullanımını ölçüyor. Anthropic tablosunda Claude Opus 5.5 yüzde 67,7, Astra yüzde 57,2 alıyor. Bu testte Claude 10,5 puan önde. Farkın yönü açık olsa da “genel zekâ puanı” gibi okunmamalı; test tasarımı, araç düzeni ve güvenlik davranışı sonucu etkiliyor.
OpenAI'ın Astra sayfasındaki şirket içi ve üçüncü taraf sonuçları, Astra'nın matematik, bilim ve siber güvenlikte güçlü bir profil sunduğunu gösteriyor. Örneğin OpenAI, Terminal-Bench Science sonucunu yüzde 64,6; GPQA Diamond sonucunu yüzde 96,0 olarak açıklıyor. Ancak Claude Opus 5.5 aynı lansman gününde çıktığı için OpenAI'ın ana karşılaştırma tablosu eski Claude sürümlerini içeriyor. Bu nedenle eski Opus 5 satırını yeni Opus 5.5 ile eşdeğer göstermedim.
Bilgi işi ve profesyonel görevler
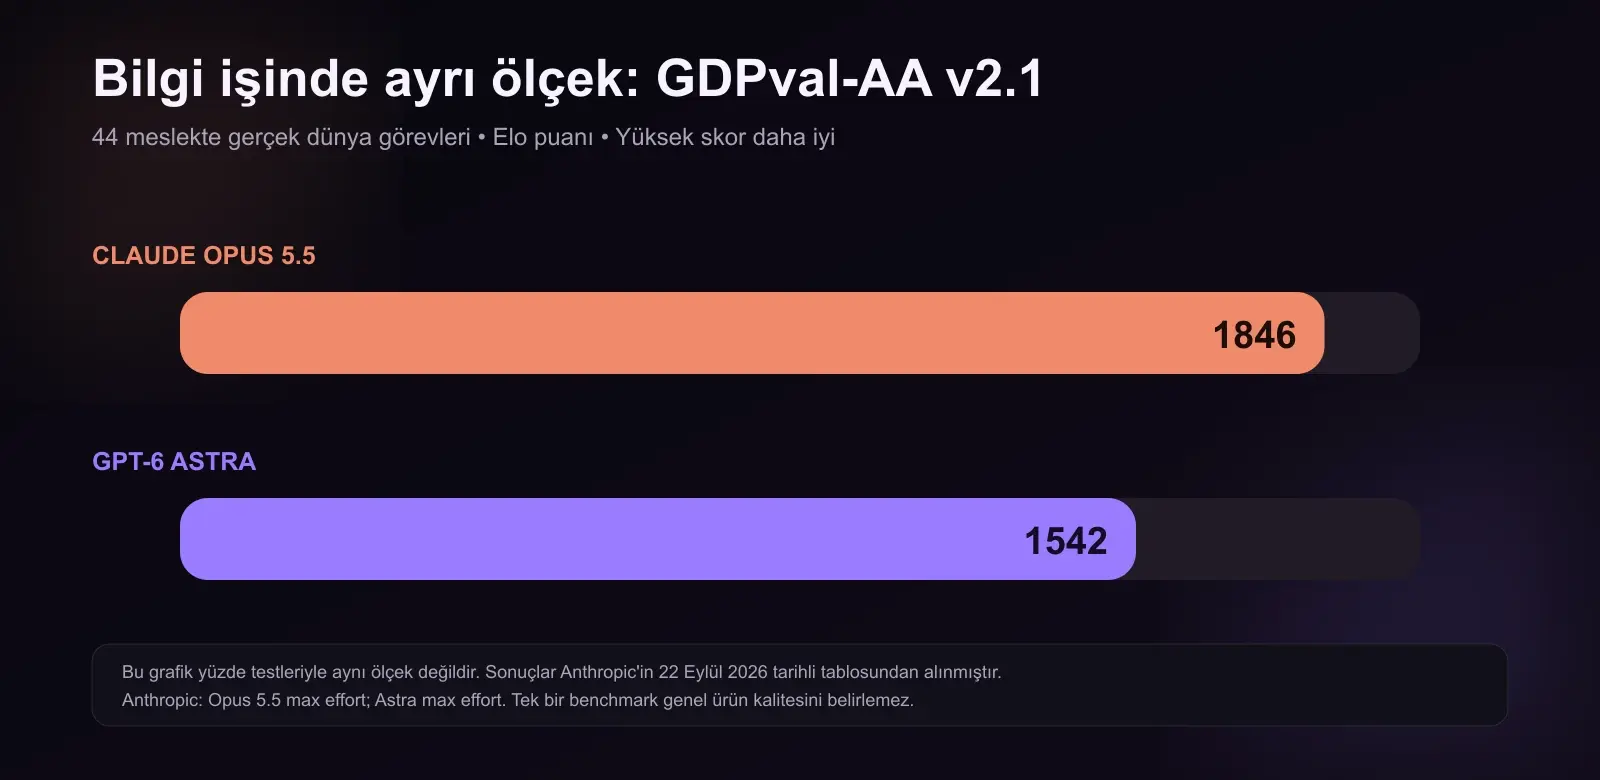
GDPval-AA v2.1, 44 meslekte gerçek dünya profesyonel görevlerini Elo ölçeğiyle değerlendiriyor. Anthropic'in açıkladığı tabloda Claude Opus 5.5 1846 Elo, GPT-6 Astra 1542 Elo alıyor. Bu sonuç, kaynak araştırması, analiz ve profesyonel teslim üretimi için Claude lehine güçlü bir işaret.
Grafiği yüzde benchmarklarından ayırdım çünkü Elo ile yüzde aynı ölçü değildir. 1846 sayısını yüzde 66,4 ile aynı eksende göstermek görsel olarak çarpıcı, analitik olarak yanıltıcı olurdu.
AutomationBench ise daha farklı bir profesyonel işi ölçüyor: bağlı uygulamalarda iş akışı yürütme. Astra yüzde 41,4, Claude yüzde 40,0. Anthropic'in dipnotuna göre bu değerlendirme Zapier tarafından yapılmış; Claude erken erişim değerlendirmesinden, Astra ise genel liderlik tablosundan geliyor. Claude koşusunda fallback model kullanılmadığı için güvenlik müdahaleleri başarısızlık sayılmış. Sonuç bu özel testte Astra lehine, fark ise küçük.
Buradaki pratik ayrım şöyle okunabilir:
- Derin araştırma, uzun rapor, çok belgeli analiz ve karar dosyası: Claude güçlü aday.
- Uygulamalar arası otomasyon, ChatGPT Work, belge, tablo ve sunum üretimini tek ekosistemde yürütme: Astra güçlü aday.
- Kurumsal iş akışında gerçek farkı; son dosyanın doğruluğu, biçim kurallarına uyum ve insan düzeltme süresi belirler.
API fiyatı ve kapasite karşılaştırması
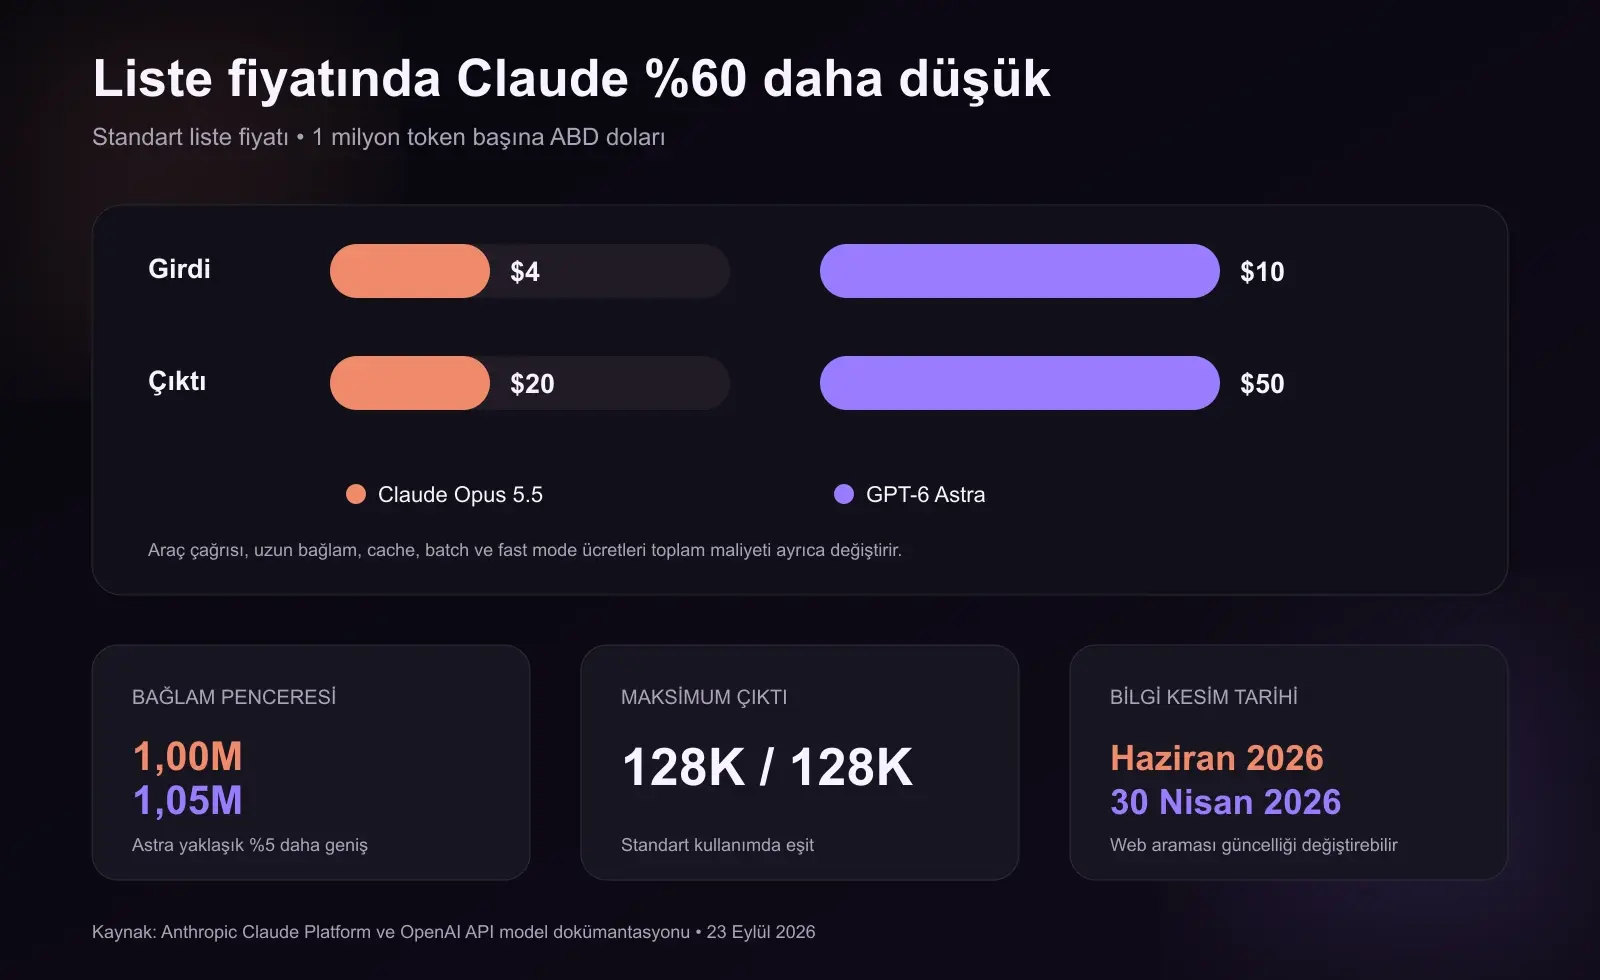
Standart liste fiyatında Claude Opus 5.5'in girdisi 4 dolar, çıktısı 20 dolar. GPT-6 Astra'nın girdisi 10 dolar, çıktısı 50 dolar. İki tarafta da Claude fiyatı yüzde 60 daha düşük; başka bir ifadeyle Astra'nın standart token fiyatı Claude'un 2,5 katı.
Basit bir örnek: bir görev 1 milyon girdi ve 200 bin çıktı tokenı kullansın. Araç, cache ve uzun bağlam eklerini dışarıda bırakırsak:
- Claude Opus 5.5: 4 dolar girdi + 4 dolar çıktı = 8 dolar
- GPT-6 Astra: 10 dolar girdi + 10 dolar çıktı = 20 dolar
Bu örnek görev başına kaliteyi ölçmez. Astra daha az tokenla veya daha az tekrar ile işi bitirirse fark daralabilir; Claude daha yüksek effort ile çok fazla araç çağrısı yaparsa maliyet artabilir. Sağlıklı metrik, yalnızca milyon token fiyatı değil kabul edilen teslim başına toplam maliyet olmalı.
Cache fiyatlarında da fark var. Claude Opus 5.5 cache okuması milyon token başına 0,20 dolar. Astra cached input fiyatı 1 dolar; cache yazma 12,50 dolar. Sağlayıcıların cache kuralları birebir aynı olmadığı için bu değerleri tek katsayıya çevirmedim.
Bağlam tarafında Astra 1.050.000, Claude 1.000.000 token sunuyor. Yaklaşık yüzde 5'lik fark tek başına belirleyici sayılmaz. Bir milyon tokenlık bağlamın tamamını doldurmak; ilgili bilgiye erişim, gecikme ve maliyet açısından her zaman doğru yöntem değildir. Dosya seçimi, arama ve özetleme stratejisi model adından daha fazla fark yaratabilir.
Tasarım, marka ve içerik üretiminde hangisi?
Her iki model de görsel girdi alıp metin üretir. İkisi de tek başına bitmiş görsel veya video motoru değildir; fakat bağlı araçlarla tasarım araştırması, arayüz denetimi, sunum, grafik, web sayfası ve üretim dosyası hazırlayabilir.
Claude Opus 5.5; uzun brief'leri, marka kılavuzlarını ve çok sayıda örnek dosyayı birlikte ele alan bilgi işinde cazip. Anthropic ayrıca Chartography testinde araçlarla yüzde 89,0 ve OSWorld 2.0 kısmi değerlendirmesinde yüzde 81,8 açıklıyor. Astra için Anthropic'in bu iki satırında doğrudan karşılaştırma değeri bulunmadığı için grafiğe eklemedim.
GPT-6 Astra, OpenAI tarafından özellikle belge, hesap tablosu, sunum, web sitesi ve profesyonel teslim üretimi için konumlandırılıyor. OpenAI Responses API'de web search, file search, image generation, code interpreter, hosted shell, apply patch, skills, computer use, MCP ve tool search desteği listeleniyor. Mevcut işiniz ChatGPT, Codex ve OpenAI araçlarında yürüyorsa entegrasyon kazancı benchmark farkından daha değerli olabilir.
Bir art director veya ajans için önerdiğim test seti şu olur:
- Aynı marka kılavuzundan 10 maddelik görsel denetim raporu çıkarın.
- Aynı kampanya brief'inden sosyal medya carousel akışı üretin.
- Aynı ekran görüntülerinden masaüstü ve mobil UI tutarsızlıklarını bulun.
- Aynı veri setinden sunum ve grafik hazırlatın.
- Aynı araştırma kaynaklarından 1.500 kelimelik, alıntıları doğrulanmış bir içerik yazdırın.
Çıktıları model adı kapalıyken doğruluk, marka tonu, revizyon sayısı, teslim süresi ve toplam maliyet üzerinden puanlayın. “Hangisi daha yaratıcı?” sorusu ancak sizin brief'iniz ve onay ölçütünüzle anlamlı hale gelir.
Güvenlik ve kurumsal kullanım
GPT-6 Astra, OpenAI'ın Preparedness Framework çerçevesinde siber güvenlik yeteneğinde Critical eşiğine ulaşan ilk modeli olarak duyuruldu. Bu yüksek yetenek, daha sıkı korumaları da beraberinde getiriyor. OpenAI, meşru güvenlik işlerinin bazen yavaşlayabileceğini, durabileceğini veya ek inceleme isteyebileceğini açıkça belirtiyor. Astra uygun API müşterileri için Zero Data Retention desteği sunuyor.
Anthropic, Opus 5.5'i ASL-3 standardı altında yayınlıyor ve Opus 5'e göre sınır aşma davranışını azalttığını bildiriyor. Üretim güvenlik önlemlerinin bazı benchmark görevlerinde eski Claude modellerine fallback yaptığını da açıklıyor. Bu şeffaflık, skor yorumunda önemli: güvenlik davranışı bazen ham başarı oranını aşağı çekebilir.
Kurumsal seçimde yalnızca “hangi model daha güvenli?” diye sormak yeterli değil. Veri saklama anlaşması, seçilen bulut bölgesi, erişim rolleri, günlükleme, insan onayı, gizli anahtar yönetimi ve sağlayıcının hassas görev politikası birlikte incelenmeli.
Hangi kullanıcı hangi modeli seçmeli?
Claude Opus 5.5 daha mantıklıysa
- Uzun süre çalışan kodlama ajanları kuruyorsanız
- Geniş kod tabanında göç, denetim ve çok dosyalı değişiklik yapıyorsanız
- Kaynaklı araştırma ve uzun profesyonel rapor üretiyorsanız
- API maliyeti doğrudan ürün marjınızı etkiliyorsa
- Bir milyon token bağlam sizin için yeterliyse
GPT-6 Astra daha mantıklıysa
- ChatGPT, Codex veya OpenAI Responses API üzerine kurulu bir ekosisteminiz varsa
- Bilimsel terminal iş akışları ana kullanım alanınızsa
- Bilgisayar kullanımı, web araması, belge, sunum ve tablo üretimini tek ürün içinde yürütüyorsanız
- 1,05 milyon tokenlık bağlam sınırına gerçekten ihtiyaç duyuyorsanız
- Yüksek siber güvenlik yeteneği gereken yetkili savunma çalışmalarınız varsa
İki modeli birlikte kullanmak mantıklıysa
Birçok ekip için en iyi mimari tek model seçmek yerine görev yönlendirmektir. Ucuz ve uzun kodlama ya da araştırma görevlerini Claude'a; OpenAI ürünleriyle iç içe belge, bilgisayar ve bilim araçlarını Astra'ya göndermek mümkün. Bu yaklaşım ancak ölçüm, hata yönetimi ve ikinci sağlayıcının operasyon maliyeti haklı çıkarıyorsa faydalı olur.
Sonuç: Claude Opus 5.5 mi GPT-6 Astra mı?
Genel amaçlı tek bir kazanan yok. Bugünkü ortak veriler Claude Opus 5.5'i kodlama ajanı, çok alanlı araçlı akıl yürütme, bilgi işi ve standart API maliyetinde öne çıkarıyor. GPT-6 Astra bilimsel terminal araştırması, AutomationBench ve OpenAI'ın geniş araç ekosistemiyle güçlü bir alternatif sunuyor.
Küçük benchmark farklarına göre karar vermek yerine gerçek işinizden 10 ila 20 görev seçin. Her model için aynı brief'i, aynı kaynakları ve aynı başarı ölçütünü kullanın. Kaliteyi kör değerlendirin; sonucun düzeltilmesi için gereken insan süresini ve toplam maliyeti kaydedin. Bir hafta sonunda hangi modelin sizin için daha iyi olduğu, lansman tablosundan çok daha net görünür.
Claude'un tek başına teknik özelliklerini görmek için Claude Opus 5.5 özellikleri ve fiyatı yazısını, Astra'nın lansmanını incelemek için GPT-6 Astra nedir yazısını okuyabilirsiniz. Yapay zekâyı marka iletişimine uygulamak için AI reklam filmi hizmetini, dijital deneyim için web tasarım ve yazılım çalışmalarını inceleyebilir; projenizi iletişim sayfasından paylaşabilirsiniz.
Sık sorulan sorular
Claude 5.5 mi ChatGPT 6 Astra mı daha iyi?
Doğru model adları Claude Opus 5.5 ve GPT-6 Astra. Kodlama ajanı, bilgi işi ve API fiyatında Claude daha avantajlı görünüyor. Bilimsel terminal araştırması ve OpenAI ürün ekosisteminde Astra öne çıkıyor. Günlük kullanım sonucu görev türüne ve ürün ayarlarına bağlı.
Claude Opus 5.5, GPT-6 Astra'dan ucuz mu?
Evet. Standart API liste fiyatında Claude'un milyon token başına girdi fiyatı 4, çıktı fiyatı 20 dolar. Astra'da aynı değerler 10 ve 50 dolar. Claude'un temel liste fiyatı yüzde 60 daha düşük. Cache, araç ve uzun bağlam kuralları toplam maliyeti değiştirir.
Hangisinin bağlam penceresi daha büyük?
GPT-6 Astra 1.050.000 token, Claude Opus 5.5 1.000.000 token bağlam sunuyor. Astra yaklaşık yüzde 5 daha geniş. İki modelin standart maksimum çıktısı 128.000 token.
Kod yazmak için Claude mu Astra mı?
Ortak lansman verisinde Claude Terminal-Bench 4.0'da yüzde 66,4; Astra yüzde 57,9 alıyor. FrontierCode Main sonuçları yüzde 54,4 ve yüzde 53,3. Bu tablo Claude'u güçlü başlangıç seçeneği yapıyor; mevcut Codex entegrasyonunuz varsa Astra'yı aynı depoda ölçmek gerekir.
Benchmark sonuçları tarafsız mı?
Bu yazıda kullanılan ortak karşılaştırma tablosu Anthropic tarafından yayınlandı ve bazı Astra değerlerini OpenAI'ın açıkladığı sonuçlardan alıyor. OpenAI'ın kendi sayfası da üretici değerlendirmeleri içeriyor. Effort, araçlar ve güvenlik koşulları tamamen eşit olmadığı için rakamları yön gösteren kanıt olarak okumak, bağımsız ve kusursuz hüküm olarak görmemek gerekir.