
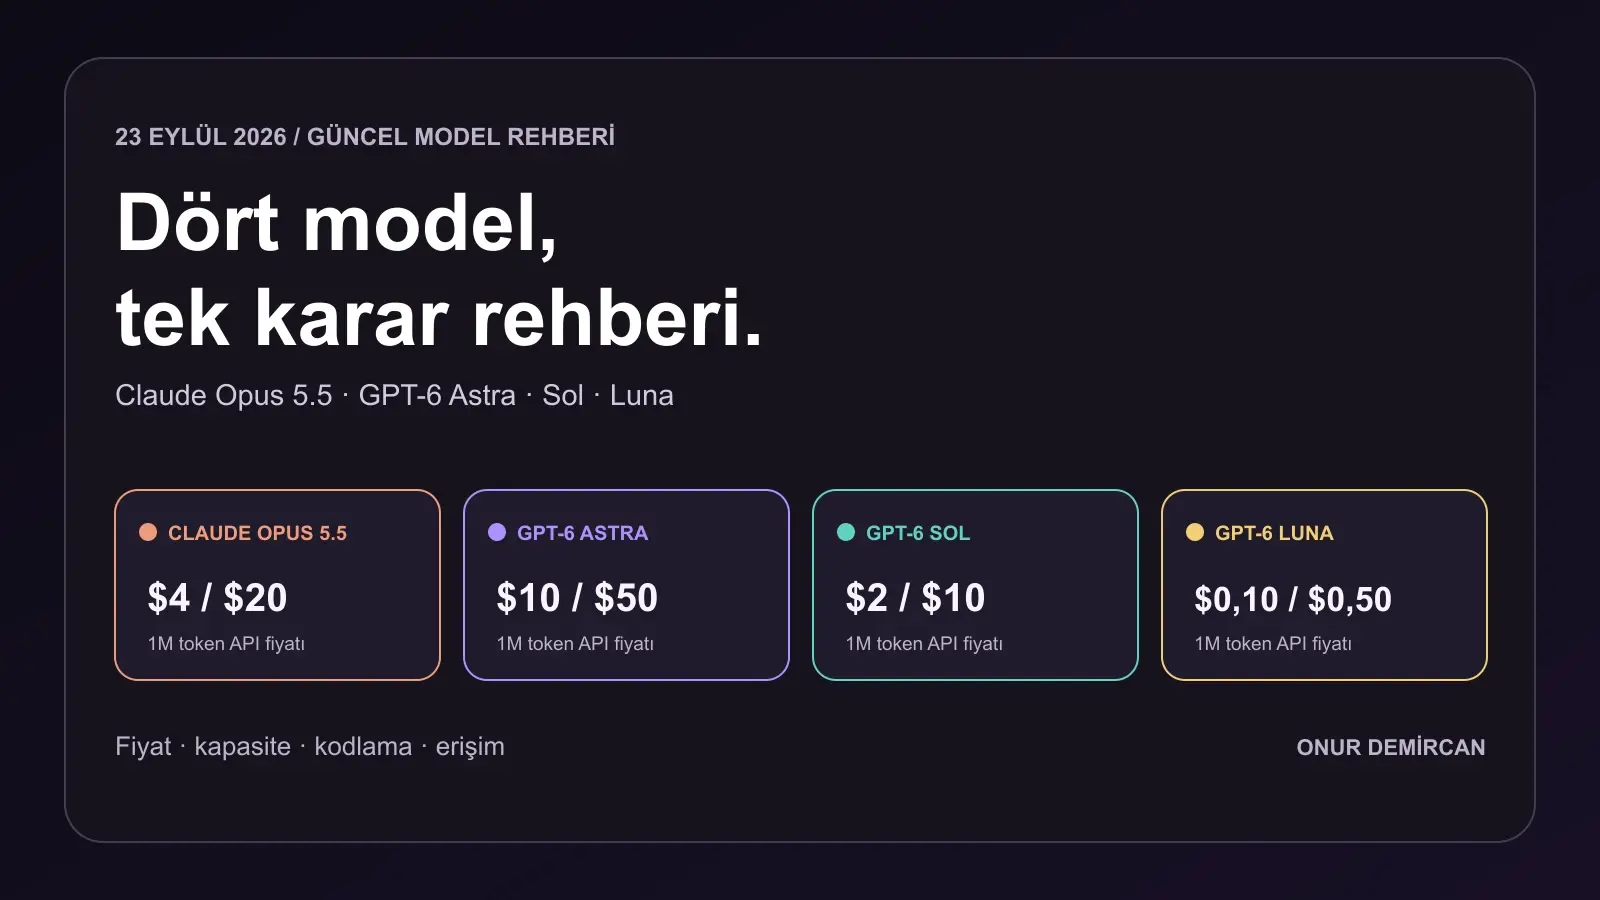
Claude Opus 5.5 ile GPT-6 Astra'yı karşılaştırdıktan yalnızca bir gün sonra tablo değişti: OpenAI, 22 Eylül 2026'da GPT-6 Sol ve GPT-6 Luna'yı duyurdu. Artık soru yalnızca “en güçlü model hangisi?” değil. Aynı iş için ne kadar kaliteye, hıza, ölçeğe ve bütçeye ihtiyacınız var? Bu rehber, dört modeli 23 Eylül 2026 itibarıyla üreticilerin yayımladığı verilerle inceliyor. API liste fiyatı, bağlam kapasitesi, gerçek benchmark sonucu ve ürün erişimini birbirinden ayırıyorum; açıklanmayan sonucu tahmin etmiyorum.
Kısa yanıt: En zor, yüksek riskli ve araçlı işler için önce Claude Opus 5.5 ile GPT-6 Astra'yı gerçek görevlerinizde deneyin. İyi kaliteyi daha düşük maliyetle arıyorsanız GPT-6 Sol'a bakın. Çok sayıda odaklı görev ve sıkı API bütçesi için GPT-6 Luna'yı test edin. Bu bir “genel sıralama” değil; hangi koşulda hangi modelin denemeye değer olduğuna ilişkin seçim çerçevesi.
GPT-6 Sol ve Luna gerçekten tanıtıldı mı?
Evet. OpenAI'ın 22 Eylül tarihli resmî duyurusu iki modeli GPT-6 ailesine ekliyor. API model kimlikleri `gpt-6-sol` ve `gpt-6-luna`. Duyuru tarihinde Plus, Pro, Business, Enterprise ve Edu kullanıcıları bunlara ChatGPT Work ve Codex üzerinden erişebiliyordu; Free ve Go kullanıcılarına masaüstü uygulamasında Luna erişimi sunuluyordu. Aynı duyuru, modellerin o anda normal Chat alanında henüz açılmadığını ve erişimin kademeli genişletileceğini de söylüyordu. Bu nedenle “ChatGPT'ye geldi” cümlesini ürün yüzeyini belirtmeden kullanmak yanıltıcı. Bugünkü kullanılabilirlik, hesabınızdaki model seçicisine ve planınıza göre kontrol edilmeli.
Claude Opus 5.5 da Anthropic tarafından 22 Eylül'de duyuruldu. GPT-6 Astra ise daha önce tanıtılan OpenAI üst seviye modeli. Dördünün aynı hafta konuşulması, sonuçların tek ve eş koşullu bir yarış gibi okunmasına neden olmamalı. Fiyat listeleri karşılaştırılabilir; farklı üreticilerin görev testleri ise çoğu zaman farklı araç, düşünme düzeyi ve güvenlik ayarıyla çalışır.
Dört modelin konumu: ne için tasarlandı?
Claude Opus 5.5: uzun ve karmaşık bilgi işi
Anthropic, Opus 5.5'ı uzun süren ajan kodlama ve bilgi işi için konumlandırıyor. Bir kod tabanını baştan sona inceleme, çok dosyalı göç, yoğun kaynak okuma ve uzun rapor hazırlama gibi görevlerde güçlü bir başlangıç adayı. Anthropic'in kendi duyuru tablosunda Terminal-Bench 4.0 skoru yüzde 66,4, FrontierCode v1.1 Main skoru yüzde 54,4, AutomationBench skoru yüzde 40,0. Bunlar sonuç, fakat ürününüzde aynı kaliteyi garanti eden puanlar değil. Koruma ayarları ve değerlendirme düzeni ayrıca belirtilmeli.
GPT-6 Astra: en yüksek OpenAI kapasitesi
OpenAI, Astra'yı ailesinin en güçlü seçeneği olarak tanımlıyor. Daha derin araştırma, karmaşık araç kullanımı, zor yazılım ve çok aşamalı planlama için düşünülmeli. OpenAI'ın yayınladığı DeepSWE v1.1 sonucu yüzde 74,1. Anthropic'in derlediği ortak tabloda Astra, Terminal-Bench Science 0.1'de yüzde 64,6; AutomationBench'te yüzde 41,4. Astra'nın güçlü olması her düşük karmaşıklıklı istekte ekonomik olduğu anlamına gelmiyor: standart kısa bağlam API çıktı fiyatı milyon token başına 50 dolar.
GPT-6 Sol: kalite ile maliyet arasındaki seçenek
Sol, Astra'dan ucuz bir alternatif olarak değil, karmaşık gündelik işlerde daha fazla deneme yapmaya uygun ayrı bir model olarak sunuluyor. OpenAI'ın duyurusunda Sol'un DeepSWE v1.1 skoru maksimum düşünme düzeyinde yüzde 68,8; Agents' Last Exam skoru yine maksimum düzeyde yüzde 56,4. AutomationBench'te xhigh düzeyinde yüzde 33,2 açıklanıyor. Bu üç sonucu tek “zeka puanı” olarak toplamak doğru olmaz. Sol için en anlamlı test, kendi kod değişikliğinizi, kaynaklı araştırmanızı veya çok adımlı iş akışınızı aynı bütçeyle kaç kez başarıyla tamamladığı.
GPT-6 Luna: yüksek hacimli, odaklı görevler
Luna'nın temel vaadi milyonlarca basit-orta zorluktaki istek için düşük birim maliyet. Ürün açıklamasında “odaklı, yüksek hacimli görevler” vurgulanıyor. Buna rağmen yalnızca sınıflandırıcı gibi düşünülmemeli: OpenAI'ın yayımladığı DeepSWE v1.1 sonucunda maksimum düşünme düzeyiyle yüzde 66,6 alıyor. Bu skor, onu her zorlu kod işi için en doğru tercih yapmaz; örnek başarısızlıklar, tekrar deneme ve insan düzeltmesi toplamı hesaplanmalı. Çok sayıda kısa ürün açıklaması, içerik etiketleme, rutin destek taslağı ve otomatik metin dönüşümü gibi işlerde denemeye değer.
API fiyatı: dört modelin aynı ölçekte görünümü
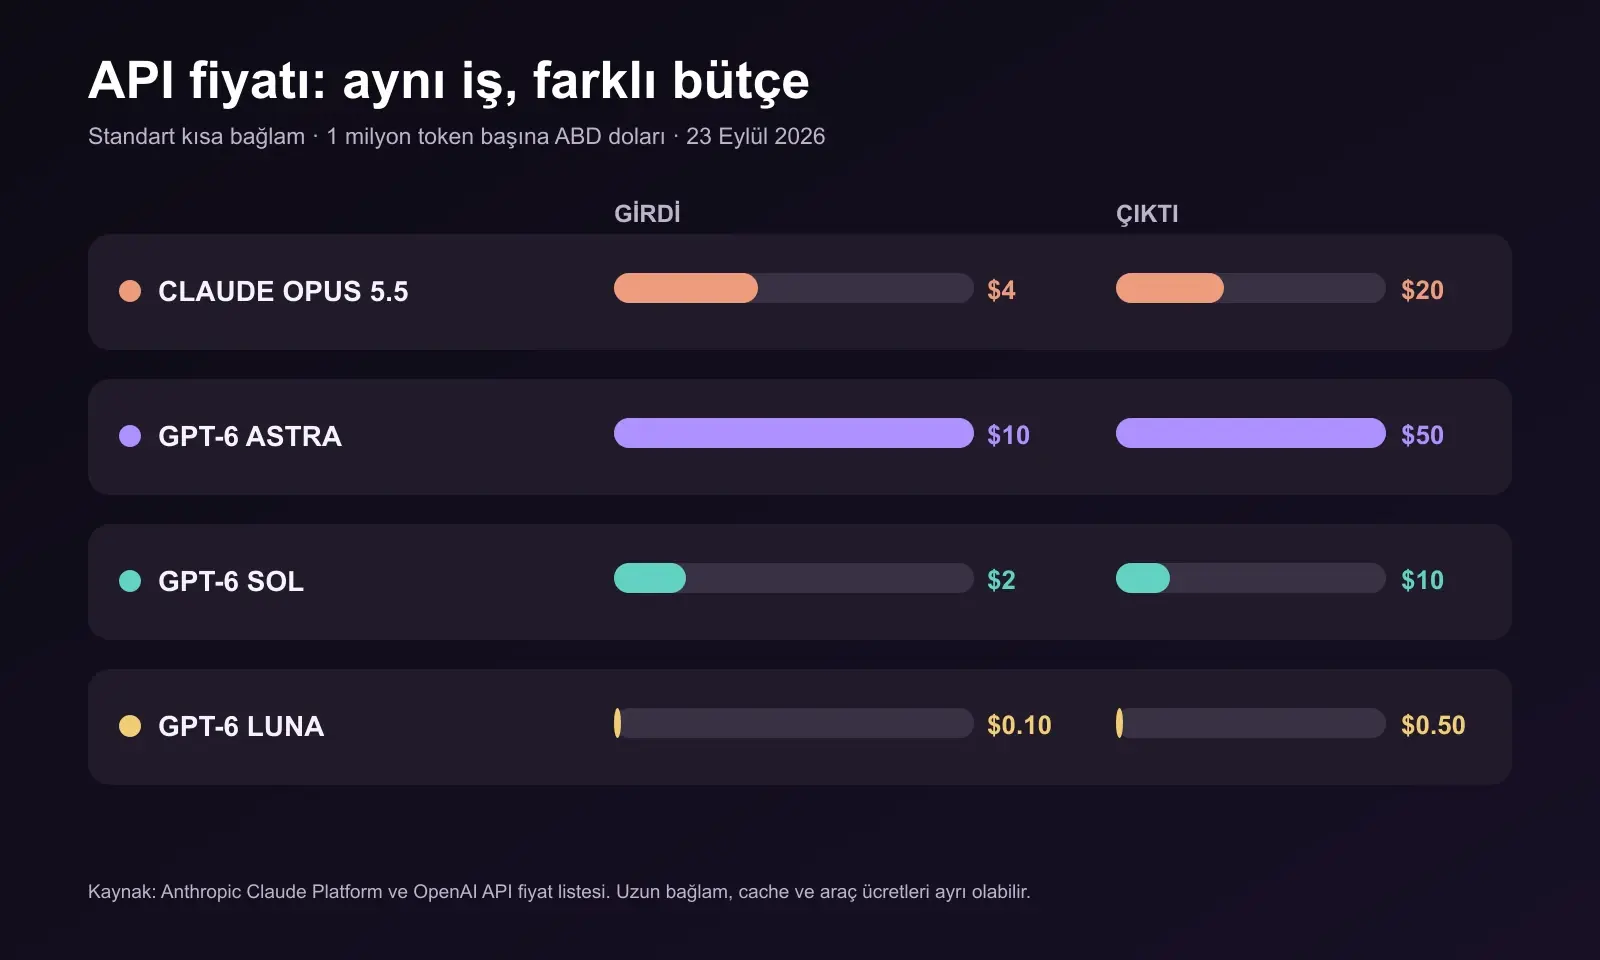
Grafikteki tutarlar ABD dolarıyla 1 milyon girdi tokenı / 1 milyon çıktı tokenı için standart, kısa bağlam liste fiyatlarıdır. Claude Opus 5.5 $4 / $20, GPT-6 Astra $10 / $50, GPT-6 Sol $2 / $10, GPT-6 Luna $0,10 / $0,50. Anthropic model sayfası ve OpenAI güncel API fiyat listesi temel alınmıştır. ChatGPT veya Claude abonelik ücretleri bu rakamlarla aynı şey değildir; API üzerinden geliştirme yapanların tüketim bedelidir.
Küçük bir örnek: 100 bin girdi ve 20 bin çıktı tokenı kullanılan tek işte, önbellek ve ek araç ücretleri hariç tutularak, temel maliyet Claude'da yaklaşık $0,80, Astra'da $2, Sol'da $0,40, Luna'da $0,02 olur. Bu, gerçek projeye verilmiş kesin fiyat teklifi değil, yayımlanmış birim fiyatla hesaplanan örnektir. Araç çağrısı, web araması, dosya işleme, prompt caching, batch/fast işlem ve yeniden denemeler faturayı değiştirebilir.
OpenAI'ın fiyat listesinde GPT-6 modelleri için uzun bağlam sütunu ayrıca bulunuyor. Luna model dokümanı, 272 bin girdi tokenını aşan isteklerde tüm isteğe daha yüksek oran uygulandığını belirtiyor. Benzer kuralın ilgili model sayfasındaki güncel sürümünü satın almadan önce kontrol edin. Bir milyonluk bağlam penceresi ile o pencereyi en düşük liste fiyatından doldurmak aynı şey değildir.
Fiyatın tek başına gizlediği şey: Düşük token fiyatlı model bir görevi üç kez tekrar ettiriyor, insan incelemesini uzatıyor veya yanlış üretim yapıyorsa toplam iş maliyeti yüksek olabilir. Ölçmeniz gereken rakam “bir milyon token fiyatı” kadar “kabul edilen sonuç başına toplam maliyet”. Özellikle ajanın saatler süren görevlerinde çıktı tokenı, araç kullanımı ve geri dönüş döngüsü önemli.
Bağlam ve çıktı kapasitesi
Anthropic'in Opus 5.5 teknik sayfası 1 milyon token bağlam ve standart kullanımda 128 bin token maksimum çıktı listeliyor. Astra, Sol ve Luna model sayfaları 1 milyon 50 bin token bağlam ve 128 bin token maksimum çıktı veriyor. Astra, Sol ve Luna'nın kâğıt üzerindeki bağlamı Claude'dan yaklaşık yüzde 5 geniş. Gerçek kullanışlılık; verilen dosyayı bulma, doğru bilgiyi hatırlama ve uzun bağlam maliyetiyle ayrıca sınanmalı.
Dördü de metin ve görsel girdisiyle çalışabiliyor; bunları birer görsel üretim modeli gibi tanıtmamak gerekir. Tasarım değerlendirmesi yaparken görsel referansı okuyabilirler, fakat son görselin üretimi için ayrı araç veya model gerekebilir. API yetenekleri ile uygulama içindeki araçlar da eşdeğer değil. “Claude arayüzündeki özellik” ya da “Codex'teki araç” doğrudan temel model benchmarkı değildir.
Kodlama karşılaştırması: eksik veriyi açık bırakıyoruz
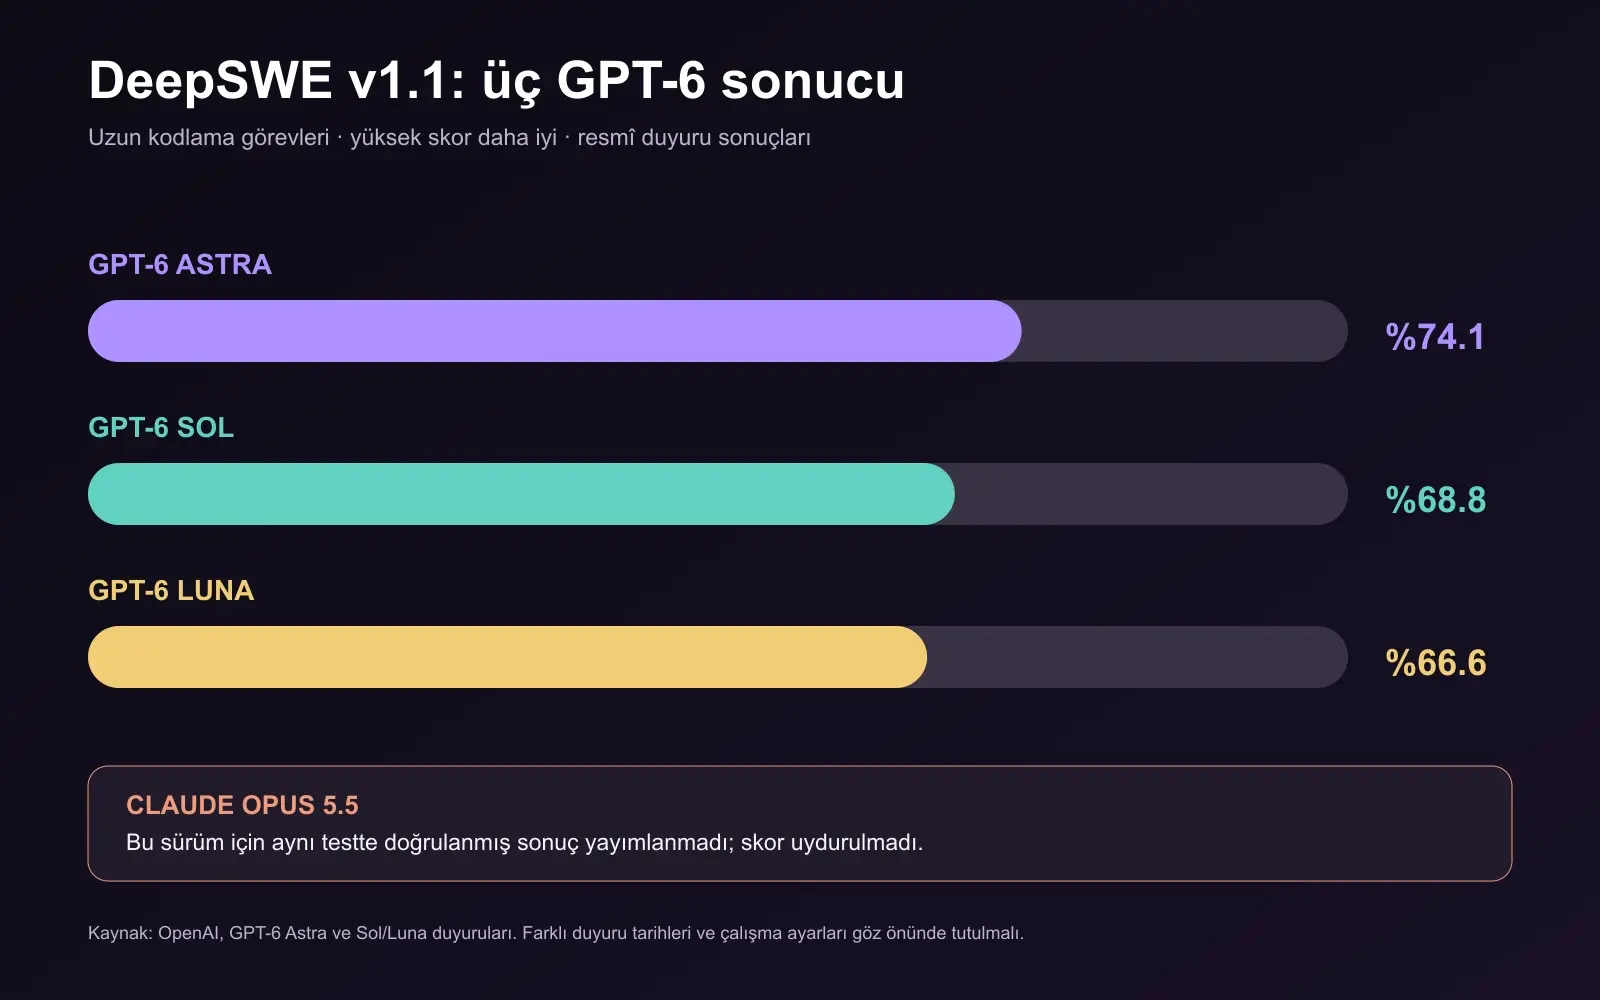
Bu grafik tek bir test ailesinde açıklanmış üç OpenAI sonucunu gösterir: Astra %74,1, Sol %68,8, Luna %66,6. Astra duyurusu ve Sol/Luna duyurusu kaynak alındı. Claude Opus 5.5 için aynı DeepSWE v1.1 düzeninde doğrulanmış bir puan bulamadığım için dördüncü çubuğu çizmedim. OpenAI'ın bazı karşılaştırmalarındaki “Claude Opus 5” rakamı 5.5 değildir; iki sürümü karıştırmak sonuçları bozar.
Claude ile Astra için iki tarafın da açıkladığı başka ortak testler var. Terminal-Bench 4.0'da Opus 5.5 %66,4, Astra %57,9; FrontierCode Main'de %54,4 ve %53,3. Ancak Anthropic notları, bazı satırlarda farklı düşünme düzeyleri ve koruma ayarları bulunduğunu açıklıyor. Bunlar “Claude her kod görevinde Astra'yı yener” hükmünü desteklemez. İki modelin ayrıntılı önceki karşılaştırmasında beş ortak benchmarkı ve yöntem farklarını ayrıca görebilirsiniz.
Sol ile Luna'nın en iyi kod çıktısı bazen Astra'ya yaklaşabilir, bazen karmaşık denetim veya uzun planlama işinde ayrışabilir. Duyuru grafiğinin ötesine geçmek için kendi deponuzdan düzeltilecek bir hata, eklenecek bir özellik ve güvenlik riski içeren bir refaktör seçin. Aynı talimatı, aynı dosyaları ve aynı testleri verin. Geçen test yüzdesine ek olarak değişikliğin incelemeye uygunluğunu ve geri alma ihtiyacını sayın.
İş akışı, araştırma ve bilgisayar kullanımı
AutomationBench verisi de dikkatli okunmalı. Anthropic'in Opus 5.5 tablosunda %40,0, Astra için %41,4 var. OpenAI, Sol'u xhigh effort ile %33,2, Astra'yı low effort ile %30,3 olarak aynı duyurusunda veriyor. “Sol 33,2; Astra 30,3, öyleyse Sol üstün” sonucu yanlıştır; Astra'nın low yerine daha yüksek düşünme düzeyindeki puanı ve görev maliyeti değişir. Ayrıca Claude ve OpenAI duyurularının değerlendirme koşulları bütünüyle eşleşmeyebilir. Luna'nın aynı koşulda resmî, kesin sayı olarak yayımlanmış bir skorunu bu grafiğe eklemiyorum.
Bilimsel terminal işlerinde Astra'nın Terminal-Bench Science 0.1 sonucu %64,6, Opus 5.5'ınki %58,7. Bu test, kaynağa dayalı araştırma yapan herkesin gerçek işini temsil etmez; bilimsel terminal ve araç akışlarına daha yakındır. Uzun çok alanlı sorularda başka testlere bakmak gerekir. Örneğin Humanity's Last Exam ile OpenAI'ın Agents' Last Exam adları benzerdir, aynı sınav değildir. Claude'un birindeki puanını Sol'un diğerindeki puanıyla aynı çubuk grafiğe koymak veri hatası olur.
Bilgisayar kullanımında da sürüm etiketleri önemli. OpenAI duyurusu Sol'un OSWorld 2.0 offline sonucunu yüzde 60,5 olarak veriyor ve bunu Claude Opus 5 ile kıyaslıyor. Bu veri Opus 5.5 karşılaştırması diye sunulamaz. Anthropic, Opus 5.5 için OSWorld 2.0'da yüzde 81,8 kısmi ödül bildiriyor; ama test düzenekleri ve araçlar farklıyken iki duyuru puanından tek kazanan çıkarılamaz.
Tasarımcı, marka ve ekip için hangisini seçmeli?
Marka stratejisi ve hassas metin: Uzun müşteri brief'i, çok sayıda kaynak ve tutarlı ton gerekiyorsa Opus 5.5 ile Astra'yı yan yana deneyin. İkisine aynı araştırma bağlantılarını ve marka rehberini verin. Kaynak göstermeyen iddiaları işaretleyin. Modelin yazdığı ilk taslağın güzel görünmesi yeterli değil; marka, doğruluk ve revizyon süresi birlikte değerlendirilmeli.
Web, UI/UX ve kod geliştirme: Bir dosyayı düzenleme veya küçük bileşen için Sol ile başlayıp zor mimari kararlarda Astra ya da Opus'a yükseltmek ekonomik olabilir. Luna'yı tekrar eden sınıflandırma, varyasyon ve basit dönüşüm işlerinde deneyin. En pahalı modeli her soruda çalıştırmak hız ve bütçe sorununa dönüşebilir. En ucuz modeli her kritik işte kullanmak da onarım maliyetini büyütebilir.
Sosyal medya ve içerik operasyonu: Haftalık onlarca açıklama, başlık alternatifi veya ürün varyasyonu için Luna ve Sol pratik adaylar. Kampanya fikri, kültürel hassasiyet ve büyük bir marka için son redaksiyonda insan editör şart. Yapay zekâ çıktısını otomatik yayımlamadan önce marka iddialarını, lisansları ve hedef kitleye uygunluğu inceleyin.
Yapay zekâ reklam filmi üretimi: Bu dört modelin rolü araştırma, senaryo taslağı, storyboard metni, çekim planı ve revizyon kontrolünde olabilir. Video üretim kalitesi bu dört modelin tek başına karşılaştırdığı bir özellik değil; video modeli, kurgu ve insan art direction'ı ayrı seçilir. AI reklam filmi sürecine bakarken model seçimini tüm prodüksiyonun yalnız bir kalemi olarak değerlendirin.
Seçimi gerçek bir denemeye dönüştürün
Dört modele de aynı on görevlik kısa deneme setini verin: birkaç kod değişikliği, birkaç kaynaklı araştırma, bir marka metni ve birkaç yapılandırılmış dönüşüm. Başarılı yanıt için ölçütü başlamadan yazın. Kodda test, araştırmada doğru alıntı, marka metninde ton uyumu, otomasyonda doğru alan eşlemesi ölçülebilir. Her görevde toplam token, API maliyeti, süre, insan düzeltmesi ve yeniden deneme sayısını kaydedin. Böylece modelin yalnız tek cevap puanını değil, iş akışına gerçek katkısını görürsünüz.
Farklı düşünme seviyelerini aynıymış gibi kıyaslamayın. Önce “her modelin makul varsayılan ayarı” ile karşılaştırın; sonra kalite gerektiğinde daha yüksek ayarı deneyin. Erişim planı veya API oran sınırı seçimde kritikse, üretime geçmeden önce hesabınızda kontrol edin. Lansman günü açıklaması her hesabın aynı anda aynı menüye sahip olduğu anlamına gelmez.
Son karar
Opus 5.5, resmî tablolarda güçlü kodlama ve bilgi işi sonuçları ile Astra'dan düşük temel API fiyatı sunuyor. Astra, OpenAI'ın üst modeli; özellikle yüksek karmaşıklıklı, araçlı ve bilimsel işlerde denemeye değer. Sol, daha düşük bedelle çok sayıda ciddi görev yürütmek için dengeli duruyor. Luna, en düşük API fiyatıyla yüksek hacimli, odaklı işlemleri ölçeklemeyi mümkün kılıyor. Tek bir benchmark tablosu dört modeli mutlak sıralamaya yetmiyor. Doğru cevap, kendi işinizde kabul edilen sonuç başına kalite, süre ve maliyet ölçümünden çıkacak.
Sık sorulan sorular
GPT-6 Sol ve GPT-6 Luna ChatGPT'de var mı?
OpenAI'ın 22 Eylül duyurusu bunların ChatGPT Work ve Codex'te sunulduğunu, Free/Go masaüstünde Luna bulunduğunu ve normal Chat alanına kademeli açılmanın planlandığını söylüyor. Erişiminiz için güncel hesap menüsünü kontrol edin; duyuru tarihindeki erişim ile bugünkü hesap durumu aynı olmayabilir.
GPT-6 Luna neden bu kadar ucuz?
OpenAI, Luna'yı odaklı ve yüksek hacimli işler için konumlandırıyor. Standart kısa bağlam API liste fiyatı milyon girdi tokenında 0,10 dolar, milyon çıktı tokenında 0,50 dolar. Düşük fiyat, her görevde aynı başarı veya maliyet garantisi vermez; tekrar deneme ve insan düzeltmesini ekleyin.
Claude Opus 5.5 mi GPT-6 Astra mı kodlama için iyi?
Paylaşılan Terminal-Bench 4.0 ve FrontierCode Main verilerinde Opus 5.5 önde; bilimsel terminal testinde Astra önde. DeepSWE grafiğinde Astra puanı var, Opus 5.5 için bu sürüme ait karşılaştırılabilir puan yok. Kendi depo görevinizde ölçmeden kesin karar vermeyin.
GPT-6 Sol ile Luna arasındaki fark ne?
Sol daha zor genel görevler için kalite-maliyet dengesi; Luna odaklı ve çok sayıda istek için düşük maliyet sunuyor. OpenAI'ın açıkladığı DeepSWE v1.1 puanları Sol'da yüzde 68,8, Luna'da yüzde 66,6. Aradaki fark ve gerçek maliyet, sizin görev karışımınızda değişebilir.
Fiyat grafiği ChatGPT aboneliği mi?
Hayır. Grafik, geliştiricilerin API üzerinden kullandığı standart kısa bağlam token liste fiyatını gösteriyor. ChatGPT ve Claude planları ayrı ürünler, kullanım sınırları ve ücretler taşır.
Resmî kaynaklar
- OpenAI: GPT-6 Sol ve Luna duyurusu, erişim ve benchmarklar
- OpenAI: GPT-6 Astra duyurusu ve DeepSWE sonucu
- OpenAI Developers: API fiyatları ve uzun bağlam oranları
- OpenAI Developers: Astra model sayfası
- OpenAI Developers: Sol model sayfası
- OpenAI Developers: Luna model sayfası
- Anthropic: Claude Opus 5.5 duyurusu, benchmark tablosu
- Anthropic Claude Platform: Opus 5.5 fiyat ve teknik özellikleri